

B树(B 即 Banlance 多路平衡查找树)
- 每个节点都存储key和data,所有节点组成这个树,并且叶子节点指针都为null
- 索引字段没有冗余,任何一个关键字只出现在一个节点中
- 搜索可能在非叶子节点结束
B+树
- 只有叶子节点存储data,叶子节点包含了这颗树所有的键值,叶子节点不存储指针,非叶子节点不存储数据
- B+树上增加了顺序访问指针,也就是每个叶子节点增加一个指向相邻叶子节点的指针,适合范围查找
- 索引字段有冗余,关键字
- 搜索必须到叶子节点


InnoDB会生成两个文件
1、.frm 表定义,描述表结构
2、.ibd 索引 + 数据
MyISAM会生成三个文件
1、.frm 表定义,描述表结构
2、.MYD "D"数据信息文件,是表的数据文件
3、.MYI "I"索引信息文件,是表数据文件中任何索引的数据树。
根节点是在内存中的,然后加载磁盘中的节点到内存中
1. innodb支持事务,myisam不支持
- innodb支持外键、myisam不支持
- innodb支持表锁和行锁,但是myisam支持表锁
- innodb在5.6版本之后支持全文索引
- innodb索引的叶子节点直接存放数据,而myisam存放地址
虽然InnoDB也使用B+Tree作为索引结构,但具体实现方式却与MyISAM截然不同。
第一个重大区别是InnoDB的数据文件本身就是索引文件。从上文知道,MyISAM索引文件和数据文件是分离的,索引文件仅保存数据记录的地址。而在InnoDB中,表数据文件本身就是按B+Tree组织的一个索引结构,这棵树的叶节点data域保存了完整的数据记录。这个索引的key是数据表的主键,因此InnoDB表数据文件本身就是主索引。
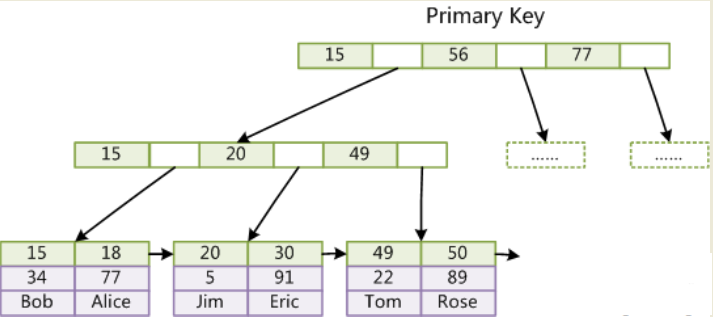
上图是InnoDB主索引(同时也是数据文件)的示意图,可以看到叶节点包含了完整的数据记录。这种索引叫做聚集索引。因为InnoDB的数据文件本身要按主键聚集,所以InnoDB要求表必须有主键(MyISAM可以没有),如果没有显式指定,则MySQL系统会自动选择一个可以唯一标识数据记录的列作为主键,如果不存在这种列,则MySQL自动为InnoDB表生成一个隐含字段作为主键,这个字段长度为6个字节,类型为长整形。
第二个与MyISAM索引的不同是InnoDB的辅助索引data域存储相应记录主键的值而不是地址。换句话说,InnoDB的所有辅助索引都引用主键作为data域。例如,下图为定义在Col3上的一个辅助索引:
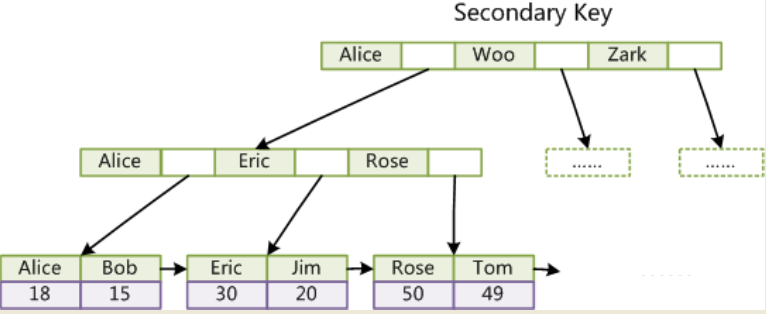
这里以英文字符的ASCII码作为比较准则。聚集索引这种实现方式使得按主键的搜索十分高效,但是辅助索引搜索需要检索两遍索引:首先检索辅助索引获得主键,然后用主键到主索引中检索获得记录。
在数据库开发中,了解不同存储引擎的索引实现方式对于正确使用和优化索引都非常有帮助。例如,知道了InnoDB的索引实现后,就很容易明白为什么不建议使用过长的字段作为主键,因为所有辅助索引都引用主索引,过长的主索引会令辅助索引变得过大。再例如,用非单调的字段作为主键在InnoDB中不是个好做法,因为InnoDB数据文件本身是一颗B+Tree,非单调的主键会造成在插入新记录时数据文件为了维持B+Tree的特性而频繁的分裂调整,十分低效,而使用自增字段作为主键则是一个很好的选择。
https://cloud.tencent.com/developer/article/1443681

我们先将数据记录按主键进行排序,分别存放在不同的页中(为了便于理解这里一个页中只存放 3 条记录,实际情况可以存放很多),除了存放数据的页以外,还有存放键值+指针的页,如图中page number=3 的页,该页存放键值和指向数据页的指针,这样的页由 N 个键值 + 指针组。
InnoDB存储引擎最小存储单位的,叫做页(Page),默认一页为16kb,假如一行数据大小是1k,那么理论上一页就可以放16条数据
主键Id类型int占4字节,bigint占8字节,指针在InnoDB中占6字节,这样算下来就是16384/14 = 1170,即每页可以放1170个指针。
一个指针指向一个存放记录的页,一个页里可以放16条数据,那么一颗高度为2的B+树就可以存放 1170 * 16=18720 条数据。同理,高度为3的B+树,就可以存放 1170 * 1170 * 16 = 21902400 条记录。
所以在 InnoDB 中 B+ 树高度一般为 1-3 层,它就能满足千万级的数据存储。
B 树
因为 B 树不管叶子节点还是非叶子节点,都会保存数据,这样导致在非叶子节点中能保存的指针数量变少(有些资料也称为扇出),指针少的情况下要保存大量数据,只能增加树的高度,导致 IO 操作变多,查询性能变低
红黑树
树层级过深,导致IO过多
Hash
哈希索引能以 O(1) 时间进行查找,但是失去了有序性:
- 无法用于排序与分组;
- 只支持精确查找,无法用于部分查找和范围查找。
InnoDB有两大类型的索引,簇集索引和普通索引
聚集索引的叶子节点存储行记录,因此InNoDB有且只有一个聚集索引。
1、如果定义了Pk,PK就是聚集索引
2、如果没有定义PK,第一个Not Null unique 列就是聚集索引
3、如果都没有,InNoDB默认创建一个隐藏的 row_id 作为聚集索引
InnoDB的普通索引的叶子节点储存主键值
聚集索引表记录的排列顺序和索引的排列顺序一致,所以查询效率快,因为只要找到第一个索引值记录,其余的连续性的记录在物理表中也会连续存放,一起就可以查询到。
缺点:新增比较慢,因为为了保证表中记录的物理顺序和索引顺序一致,在记录插入的时候,会对数据页重新排序。
为什么建主键?
如果设置了主键,那么InnoDB会选择主键作为聚集索引
为什么使用自增主键?
聚簇索引的数据的物理存放顺序与索引顺序是一致的**,即:**只要索引是相邻的,那么对应的数据一定也是相邻地存放在磁盘上的。键的顺序按照数据记录的插入顺序排列,自动有序。当一页写满,就会自动开辟一个新的页
聚簇索引的顺序和磁盘中数据的存储顺序是一致的,如果主键不是自增id,那么可以想 象,它会干些什么,不断地调整数据的物理地址、分页,当然也有其他一些措施来减少这些操作,但却无法彻底避免。但,如果是自增的,那就简单了,它只需要一 页一页地写,索引结构相对紧凑,磁盘碎片少,效率也高
3. 会出现页分裂


1. 保持一致性: 当数据库表进行DML操作时,同一行记录的页地址会发生改变,因非主键索引保存的是主键的值,无需进行更改。
2. 节省存储空间: Innodb数据本身就已经汇聚到主键索引所在的B+树上了, 如果普通索引还继续再保存一份数据,就会导致有多少索引就要存多少份数据。
回表查询:
先定位主键值,再定位行记录。即先通过普通索引定位到主键值,然后回表扫描主键的索引树,定位到行记录
覆盖索引:
只需要在一棵索引书上就能获取SQL所需要的的所有列数据,无需回表操作,速度更快
如何实现覆盖索引:
将被查询的字段,建立到联合索引中
create table user(
	id int primary key,
    name varchar(255),
    sex varchar(2),
    index(name)
) engine = innodb;


select id,name from user where name = 'zhangsan';
能够命中name索引,索引叶子节点存储了主键Id,通过name的索引树既可以获得id和name,无需回表,符合覆盖索引


select id,name,sex from user where name = 'zhangsan';
会产生回表操作,因为name索引树上无法获得sex字段,会回表到主键索引树查找行记录获得sex的值,不符合索引覆盖
如何利用索引覆盖优化SQL
create table user(
	id int primary key,
    name varchar(255),
    sex varchar(2),
    index(name)
) engine = innodb;-
全表count查询优化
select count(name) from user;
不能利用索引覆盖。
添加索引:
alter table user add key(name);
就能够利用索引覆盖提效
-
列查询回表优化
单列索引(name)升级为联合索引(name, sex),即可避免回表
-
分页查询
select id,name,sex ...order by name limit 500,100;
将单列索引(name)升级为联合索引(name, sex),也可以避免回表
- 如果where条件是索引字段,加的是行锁,如果是非索引字段,加的是表锁
- 如果where条件是索引字段,但是区分度不高,mysql优化默认是非索引字段,加的也是表锁
Explain 用来分析 SELECT 查询语句,开发人员可以通过分析 Explain 结果来优化查询语句。
比较重要的字段有:
- select_type : 查询类型,有简单查询、联合查询、子查询等
- key : 使用的索引
- rows : 扫描的行数
- 减少请求的数据量
- 只返回必要的列:最好不要使用 SELECT * 语句。
- 只返回必要的行:使用 LIMIT 语句来限制返回的数据。
- 缓存重复查询的数据:使用缓存可以避免在数据库中进行查询,特别在要查询的数据经常被重复查询时,缓存带来的查询性能提升将会是非常明显的。
- 减少服务器端扫描的行数
最有效的方式是使用索引来覆盖查询。
-
切分大查询
一个大查询如果一次性执行的话,可能一次锁住很多数据、占满整个事务日志、耗尽系统资源、阻塞很多小的但重要的查询。
DELETE FROM messages WHERE create < DATE_SUB(NOW(), INTERVAL 3 MONTH);

rows_affected = 0
do {
    rows_affected = do_query(
    "DELETE FROM messages WHERE create  < DATE_SUB(NOW(), INTERVAL 3 MONTH) LIMIT 10000")
} while rows_affected > 0
-
分解大连接查询
将一个大连接查询分解成对每一个表进行一次单表查询,然后在应用程序中进行关联,这样做的好处有:
-
让缓存更高效。对于连接查询,如果其中一个表发生变化,那么整个查询缓存就无法使用。而分解后的多个查询,即使其中一个表发生变化,对其它表的查询缓存依然可以使用。
-
分解成多个单表查询,这些单表查询的缓存结果更可能被其它查询使用到,从而减少冗余记录的查询。
-
减少锁竞争;
-
在应用层进行连接,可以更容易对数据库进行拆分,从而更容易做到高性能和可伸缩。
-
查询本身效率也可能会有所提升。例如下面的例子中,使用 IN() 代替连接查询,可以让 MySQL 按照 ID 顺序进行查询,这可能比随机的连接要更高效。
SELECT * FROM tag
JOIN tag_post ON tag_post.tag_id=tag.id
JOIN post ON tag_post.post_id=post.id
WHERE tag.tag='mysql';
SELECT * FROM tag WHERE tag='mysql';
SELECT * FROM tag_post WHERE tag_id=1234;
SELECT * FROM post WHERE post.id IN (123,456,567,9098,8904);
-
TINYINT, SMALLINT, MEDIUMINT, INT, BIGINT 分别使用 8, 16, 24, 32, 64 位存储空间,一般情况下越小的列越好。
INT(11) 中的数字只是规定了交互工具显示字符的个数,对于存储和计算来说是没有意义的。
做这个限制有两个原因:
一是优化器很弱,涉及多个表的查询,往往得不到很好的查询计划
二是执行器很弱,只有nested loop join,block nested loop join和index nested loop join。
-
nested loop join就是分别从两个表读一行数据进行两两对比,复杂度是n^2
-
block nested loop join是分别从两个表读很多行数据,然后进行两两对比,复杂度也是n^2,只是少了些函数调用等overhead
-
index nested loop join是从第一个表读一行,然后在第二个表的索引中查找这个数据,索引是B+树索引,复杂度可以近似认为是nlogn,比上面两个好很多,这就是要保证关联字段有索引的原因
重构查询的方式里面提到,需要考虑实际情况,看看是否有必要将一个复杂的查询分解成多个简单的查询,并不一定要把所有的工作全都移交给数据库
Join拆解的核心就是利用In关键字
确实需要两个表里的数据链接在一起,我们可以做个冗余,建表的时候,就把这些列放在一个表里,比如一开始有student(id, name),class(id, description),student_class(student_id, class_id)三张表,这样是符合数据库范式的(第一范式,第二范式,第三范式,BC范式等),没有任何冗余,但是马上就不符合“编程规范“了,那我们可以用一张大表代替它,student_class_full(student_id, class_id, name, description),这样name和description可能要被存储多份,但是由于不需要join了,查询的性能就可以提高很多了。
简单来说MySQL对分页的支持是通过limit子句。请看下面的例子。
limit关键字的用法是
LIMIT [offset,] rows
offset是相对于首行的偏移量(首行是0),rows是返回条数。

# 每页10条记录,取第一页,返回的是前10条记录
select * from tableA limit 0,10;
# 每页10条记录,取第二页,返回的是第11条记录,到第20条记录,
select * from tableA limit 10,10;
这里提一嘴的是,MySQL在处理分页的时候是这样的:
limit 1000,10 - 过滤出1010条数据,然后丢弃前1000条,保留10条。当偏移量大的时候,性能会有所下降。
limit 100000,10 - 会过滤10w+10条数据,然后丢弃前10w条。如果在分页中发现了性能问题,可以根据这个思路调优
即使前10000个会扔掉,mysql也会通过二级索引上的主键id,去聚簇索引上查一遍数据,这可是10000次随机io,自然慢成哈士奇。这里可能会提出疑问,为什么会有这种行为,这是和mysql的分层有关系,limit offset 只能作用于引擎层返回的结果集
解决方案
https://mp.weixin.qq.com/s/iFVbwnYY2gJqfuYAA6c-Aw
-
利用子查询 - 利用表的覆盖索引来加速分页查询
SELECT * from blog where id >= (SELECT id from blog LIMIT 1766131,1) LIMIT 20;
-
利用连接 - 利用表的覆盖索引来加速分页查询
SELECT * from blog t1 JOIN (SELECT id from blog LIMIT 1766131, 20) t2 on t1.id = t2.id
-
复合索引优化
数据表 collect
collect ( id, title ,info ,vtype) ,
title varchar(20)  定长
info  text,
id    int          主键
vtype tinyint      索引

select id,title from collect limit 90000,10;
很慢

select id from collect order by id limit 90000,10;
很快 因为用到id主键索引


select id,title from collect where id>=(select id from collect order by id limit 90000,1) limit 10;
很快 因为用到id主键索引

select id from collect where vtype=1 order by id limit 90000,10;
很慢
vtype 做了索引了啊?怎么会慢呢?vtype做了索引是不错,如果直接使用
select id from collect where vtype=1 limit 1000,10;
是很快的,基本上0.05秒,可是提高90倍,从9万开始,那就是0.05*90=4.5秒的速度了。和测试结果8-9秒到了一个数量级。
-
count(*) 包括了所有的列,相当于行数,在统计结果的时候,不会忽略列值为NULL
-
count(1) 包括了忽略所有列,用1代表代码行,在统计结果的时候,不会忽略列值为NULL
-
count(列名) 只包括列名那一列,在统计结果的时候,会忽略列值为空(这里的空不是只空字符串或者0,而是表示null)的计数,即某个字段值为NULL时,不统计。
-
列名为主键,count(列名)会比count(1)快 。列名不为主键,count(1)会比count(列名)快。
-
如果表多个列并且没有主键,则 count(1) 的执行效率优于 count(*) 。
-
如果有主键,则 select count(主键)的执行效率是最优的。
-
如果表只有一个字段,则 select count(*)最优。
-
SELECT *,需要数据库先 Query Table Metadata For Columns,一定程度上为数据库增加了负担
-
索引问题
-
select col1 from table和select * from tableruguo col1有索引 ,mysql 是可以不用读 data,直接使用 index 里面的值就返回结果的。一旦用了 select *,就会有其他列需要读取,这时在读完 index 以后还需要去读 data 才会返回结果,这样就造成了额外的性能开销。
-
能够更加有效的过滤数据
-
简称ICP,在Mysql5.6的版本上推出,用于优化查询。
-
在不使用ICP的情况下,在使用非主键索引(又叫普通索引或者二级索引)进行查询时,存储引擎通过索引检索到数据,然后返回给MySQL服务器,服务器然后判断数据是否符合条件
-
在使用ICP的情况下,如果存在某些被索引的列的判断条件时,MySQL服务器将这一部分判断条件传递给存储引擎,然后由存储引擎通过判断索引是否符合MySQL服务器传递的条件,只有当索引符合条件时才会将数据检索出来返回给MySQL服务器
-
索引条件下推优化可以减少存储引擎查询基础表的次数,也可以减少MySQL服务器从存储引擎接收数据的次数。
-
索引下推在非主键索引上的优化,可以有效减少回表的次数,大大提升了查询的效率。
Mysql5.6之前的版本
- 5.6之前的版本是没有索引下推这个优化的,因此执行的过程如下图:

- 会忽略age这个字段,直接通过name进行查询,在(name,age)这课树上查找到了两个结果,id分别为2,1,然后拿着取到的id值一次次的回表查询,因此这个过程需要回表两次。
Mysql5.6及之后版本
- 5.6版本添加了索引下推这个优化,执行的过程如下图:

- InnoDB并没有忽略age这个字段,而是在索引内部就判断了age是否等于20,对于不等于20的记录直接跳过,因此在(name,age)这棵索引树中只匹配到了一个记录,此时拿着这个id去主键索引树中回表查询全部数据,这个过程只需要回表一次。
内部优化器会进行优化,对于n张表会有 n! 的算法,会计算出最优的组合。会极大的消耗CPU和内存,耗时严重,建议多表join,将其进行拆分出不同的查询
联合索引,为什么遵守最左前缀原则
假设有联合索引(A, B)
A是有序的,B是无序的,当A相等时,B是有序的。
B是无序的,无法通过索引树进行二分查找
如果查询A>某个值且B=某个值,索引也会失效,同样原理,A>某个值,但是B是无序,无法在索引树上进行二分查找
like同理
可以。通过覆盖索引来进行优化,类型为index